Calculateur d’erreur standard de mesure
Estimez l’erreur de mesure d’un score de test. Indiquez l’écart-type des scores et le coefficient de fidélité.
Apprenez à faire le calcul vous-mêmeSaisissez vos valeurs
Les résultats se mettent à jour pendant la saisie.
Comment saisir vos données
Saisissez l’écart-type des scores dans le premier champ et la fidélité du test dans le second. La fidélité est un coefficient entre 0 et 1, par exemple 0,85. Utilisez des nombres sans unité ajoutée dans les champs.
Erreur standard de mesure
L’erreur standard de mesure décrit l’incertitude liée à la mesure d’un score individuel dans la théorie classique des tests. Elle se calcule à partir de l’écart-type des scores et du coefficient de fidélité du test. Elle est distincte de l’erreur standard d’une moyenne et n’est pas, à elle seule, une marge à 95 %.
Faites le calcul vous-même
Supposons que les scores d’un test aient un écart-type de 10 points et une fidélité de 0,84.
Suivez cet exemple détaillé, puis reprenez les étapes avec vos propres valeurs.
Calculez le complément de la fidélité
1 − fidélité = 1 − 0.84 = 0.16.Prenez sa racine carrée
√0.16 = 0.4.Multipliez par l’écart-type des scores
SEM = SD × √(1 − fidélité) = 10 × 0.4 = 4 points.
L’erreur standard de mesure (SEM) décrit l’incertitude de mesure des scores individuels. Elle diffère de l’erreur standard d’une moyenne d’échantillon. Saisissez la fidélité sous forme de coefficient entre 0 et 1.
Vérifiez votre réponse dans le calculateurIntégré à PaperSurvey.io
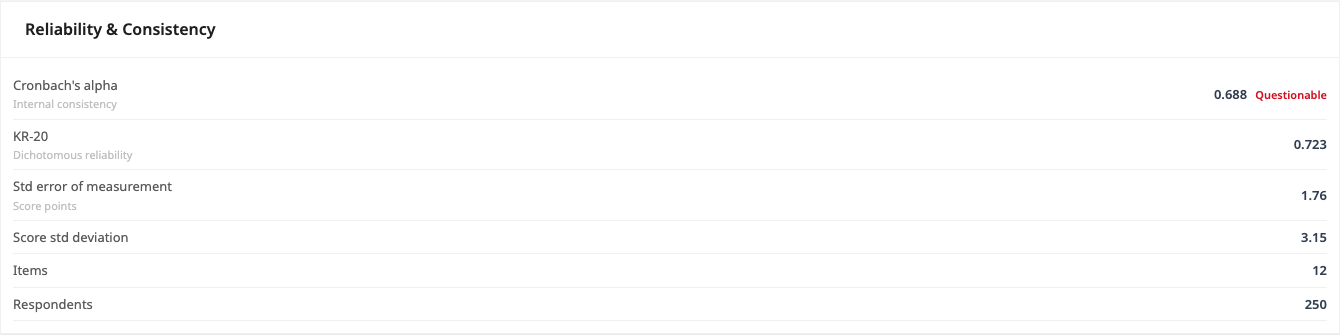
Consultez l’erreur standard de mesure dans le widget Reliability & Consistency pour évaluer l’incertitude des scores individuels au test.
Domaines d’utilisation
- Enseignants: Un enseignant examine l’incertitude des notes pour éviter de surinterpréter une petite différence, par exemple entre 70 et 72.
- Équipes RH et de recrutement: Une équipe RH évalue la précision des scores d’un test d’aptitude avant de les utiliser dans la comparaison des candidats.
- Équipes d’enquête et de recherche: Un chercheur utilise l’erreur de mesure pour présenter l’incertitude des scores d’un questionnaire avec des hypothèses et un niveau de confiance explicites.
Que décrit l’erreur standard de mesure ?
L’erreur standard de mesure estime la dispersion des erreurs autour du score vrai dans la théorie classique des tests. Elle vaut écart-type × √(1 − fidélité). À écart-type constant, une fidélité plus élevée donne une erreur de mesure plus faible.
Quand l’utiliser ?
Utilisez cet outil pour apprécier la précision d’un score individuel dans un test, un examen ou une échelle. Il nécessite un écart-type et un coefficient de fidélité adaptés au même instrument et à la population étudiée. Le résultat fournit une base pour discuter de l’incertitude de mesure ; il ne suffit pas à décider si deux scores diffèrent significativement ou si une personne doit être admise.
Que signifie le résultat ?
Le résultat s’exprime dans l’unité du score, par exemple en points d’examen. Sous des hypothèses appropriées d’erreurs normales, ±1 erreur standard correspond approximativement à une couverture de 68 %, et ±1,96 à 95 %. Ces repères ne sont pas des garanties pour chaque individu. Une erreur plus faible indique une meilleure précision à échelle comparable ; il n’existe pas de seuil universel.
Erreurs à éviter
Saisissez la fidélité sous forme de coefficient, par exemple 0,85 et non 85. Ne confondez pas l’écart-type des scores avec l’erreur standard de la moyenne. Utilisez des estimations cohérentes provenant du même test et d’une population pertinente. L’erreur de mesure ne constitue ni un seuil de réussite ni un jugement sur la validité du test.
Comment utiliser ce calculateur
- Calculez l’écart-type des scores avec une méthode adaptée, puis saisissez-le dans le premier champ.
- Saisissez le coefficient de fidélité entre 0 et 1 dans le second champ, par exemple 0,85.
- Consultez l’erreur standard de mesure, calculée automatiquement.
- Interprétez-la comme une mesure de précision d’un score individuel. Pour une marge à un niveau de confiance donné, appliquez le multiplicateur approprié sous les hypothèses retenues.
Exemple détaillé
Avec un écart-type de 10 points et une fidélité de 0,84, l’erreur standard de mesure vaut 4 points. Autour d’un score de 70, l’intervalle 66–74 correspond à ±1 erreur standard. Il ne s’agit pas d’un intervalle à 95 % : sous une approximation normale appropriée, ±1,96 erreur standard donnerait environ 62,2–77,8.
Questions fréquentes
Que saisir dans chaque champ ?
Indiquez l’écart-type des scores dans le premier champ et le coefficient de fidélité dans le second. Ce coefficient doit être compris entre 0 et 1, par exemple 0,80.
Où trouver l’écart-type ?
Calculez-le à partir des scores avec un logiciel statistique, un tableur ou notre calculateur d’écart-type. Choisissez la version d’échantillon ou de population correspondant à votre méthode d’estimation.
Où trouver le coefficient de fidélité ?
Consultez le manuel du test ou votre rapport d’analyse. L’alpha de Cronbach est un indicateur courant de cohérence interne, mais le coefficient de fidélité doit être adapté au test, à la population et au type d’erreur étudié.
Que signifie le résultat ?
Le résultat est une estimation de l’écart-type des erreurs de mesure, dans l’unité du score. Il aide à décrire la précision d’un score individuel. Un intervalle de confiance nécessite en plus un niveau de confiance et des hypothèses sur les erreurs ; ±1 erreur standard n’est pas une marge à 95 %.
Vaut-il mieux une valeur haute ou basse ?
À échelle et contexte comparables, une valeur plus faible indique une meilleure précision de mesure. Une valeur élevée signifie davantage d’incertitude autour des scores individuels. Comparez uniquement des valeurs exprimées sur des échelles compatibles.
Lancez votre premier questionnaire avec PaperSurvey.io
Vous pouvez commencer tout de suite : 14 jours d'essai gratuit, sans carte bancaire.