カイ二乗検定の計算ツール
2つのカテゴリ変数に関連があるかを検定します。カテゴリごとに行を分け、件数をスペースまたはカンマで区切ったクロス集計表を貼り付けてください。
計算の手順を学ぶ数値を入力
入力に応じて結果が更新されます。
データの入力方法
カテゴリの組み合わせごとの人数や件数を、表として入力します。各行の値をカンマで区切ってください。たとえば男性のコーヒー・紅茶の人数が40, 60、女性が70, 30なら、2行に分けて入力します。百分率ではなく、実際の整数の件数を使います。
カイ二乗統計量
入力内容を確認してください
有効な値を入力すると結果が表示されます。各欄のヒントやデータ入力ガイドを確認してください。
カイ二乗独立性検定は、2つのカテゴリ変数に関連があるかを調べます。たとえば、回答者の属性と飲み物の選択に関連があるかを、カテゴリの組み合わせごとの人数から検定できます。p値は、2変数が独立であるという仮説とデータの整合性を評価するために使います。
自分で計算する
例:2×2の件数表で、1行目が12, 8、2行目が8, 12です。
この計算例に沿って手順を確認し、自分の数値でも計算してみてください。
行合計、列合計、総数を求める
各行の合計は20; 各列の合計は20; N = 40期待度数を計算する
期待度数 = 行合計 × 列合計 ÷ N = 20 × 20 ÷ 40 = 各セル10各セルのカイ二乗統計量への寄与を合計する
χ² = (12 − 10)² ÷ 10 + (8 − 10)² ÷ 10 + (8 − 10)² ÷ 10 + (12 − 10)² ÷ 10 = 1.6自由度を求める
df = (行数 − 1) × (列数 − 1) = (2 − 1) × (2 − 1) = 1上側確率を調べる
P(自由度1のχ² ≥ 1.6) ≈ 0.2059カイ二乗分布表で確率の範囲を確認するか、数値計算でこの小数値を求めます。結果は0.05を上回ります。
独立した観測値の件数を使います。期待度数が小さいとカイ二乗近似の精度が低くなるため、小さな2×2表ではフィッシャーの正確確率検定を検討してください。
計算ツールで答えを確認する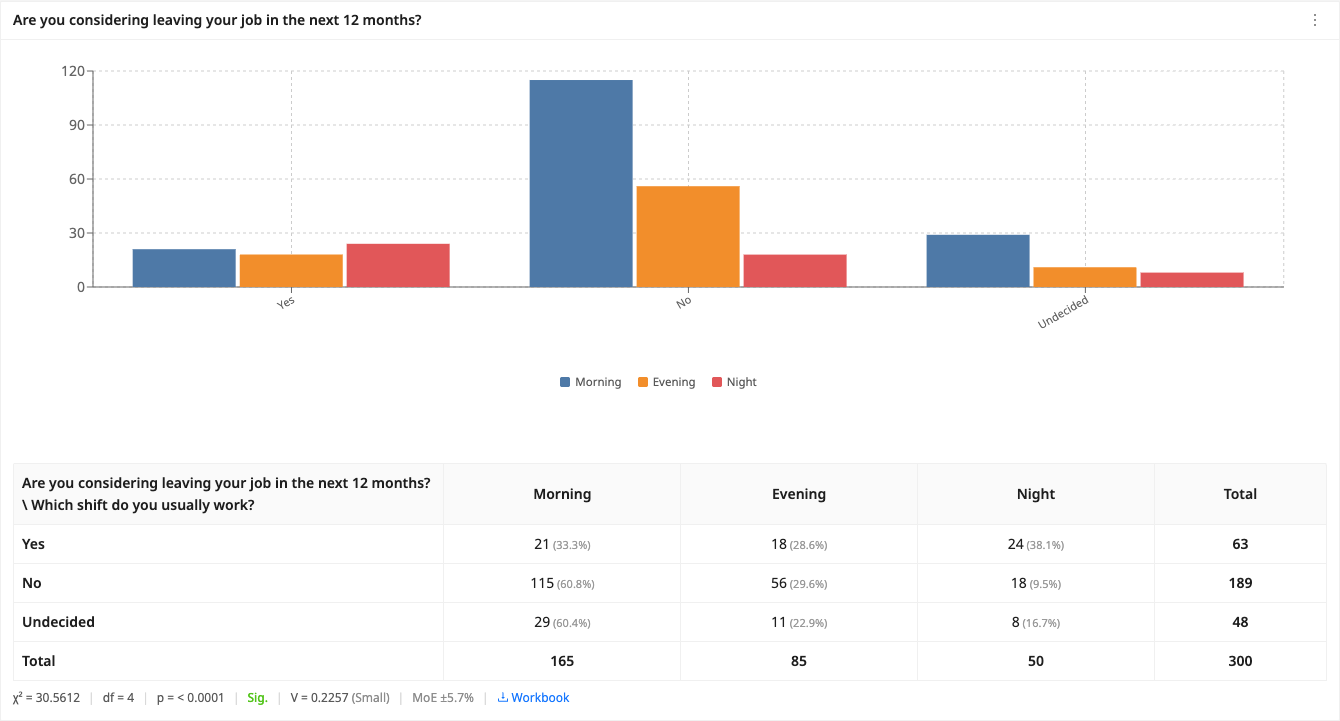
活用例
- 中小企業の経営者: カフェで短いアンケートの回答数を集計し、コーヒーと紅茶の好みが性別によって異なるかを調べます。
- 教員: 教員が、復習講座への参加と試験の合否に関連があるかを調べます。
- 人事担当者: 人事担当者が、柔軟な勤務時間への賛否が部署によって異なるかを確認します。
カイ二乗検定で何がわかりますか?
カイ二乗独立性検定は、性別と商品の好みなど、2つのカテゴリ変数の関連を調べる検定です。通常の有意水準0.05を下回るp値は、関連があることを支持する根拠になります。関連の強さはクラメールのVで表します。
どのような場面で使いますか?
回答者をカテゴリに分類する2つの質問に、関連があるかを調べたいときに使います。例えば性別とコーヒー・紅茶の好み、所属部署と「はい・いいえ」の回答などです。必要なのは、紅茶を選んだ女性の人数といった各組み合わせの件数です。平均値、個人の評点、年齢や収入の測定値をそのまま入力する検定ではありません。
結果の意味
主な結果は0から1の範囲をとるp値です。2つの変数が独立であると仮定したときに、今回と同じかそれ以上の隔たりが観測される確率を示します。値が小さいほど、独立という仮定に反する根拠が強くなります。一般的な有意水準0.05を下回れば、統計的に有意な関連があると判断します。それ以上なら、関連があると結論づけるだけの根拠がありません。カイ二乗統計量は、実際の件数と独立を仮定した期待度数の差を表し、値が大きいほど隔たりが大きいことを示します。
よくある間違い
割合や平均値ではなく、整数の実際の件数を入力してください。各回答者は1つのセルにだけ含めます。期待度数が小さい場合、特に5程度を下回る場合は近似の精度が悪くなり、標本を増やすか別の方法を使う必要があることがあります。また、関連があっても因果関係は証明されず、統計的に有意であっても実務上重要とは限りません。
この計算ツールの使い方
- 2つのカテゴリ変数に従って回答を分類し、それぞれの組み合わせに該当する人数を数えます。
- カテゴリごとに1行を使い、件数をカンマで区切った表として入力します。
- 件数が整数であることと、同じ人を重複して数えていないことを確認します。
- p値を確認します。0.05未満なら関連を示す統計的な根拠があり、それ以上なら設定した有意水準では関連があると結論づけられません。
計算例
200人に飲み物の好みを聞き、男性100人はコーヒー40人・紅茶60人、女性100人はコーヒー70人・紅茶30人でした。40, 60と70, 30を別々の行に入力すると、カイ二乗統計量は約18.2、p値は0.001を大きく下回ります。このデータでは、性別と飲み物の選択が独立であるという仮説を棄却する結果です。
よくある質問
データはどのように入力しますか?
各カテゴリを別の行にし、人数や件数をカンマまたはスペースで区切ります。2×2表なら、2つの数値を含む行を2行入力します。
各セルには何を入力しますか?
女性で紅茶を選んだ人数など、カテゴリの組み合わせに該当する人数や件数を入力します。百分率ではなく、整数の人数や件数を使ってください。
この値はどこで確認できますか?
アンケート、登録者名簿、表計算データ、販売記録などから件数を集計します。比較する2つの変数に従って各観測値を分類し、それぞれの組み合わせに該当する件数を数えてください。
p値を簡単に説明するとどうなりますか?
2つの変数が独立であると仮定したときに、今回と同じかそれ以上の隔たりが観測される確率です。p値が小さいほど、関連がないという仮定とデータが整合しにくいことを示します。
p値がいくつなら有意といえますか?
一般的には0.05を基準とし、それを下回る場合に統計的に有意な関連があると判断します。上回る場合は、設定した有意水準では関連があると結論づけられません。
有意な結果は因果関係を証明しますか?
いいえ。検定で関連が示されても、一方が他方の原因であるとは限りません。別の要因によって、その関連が生じている可能性もあります。