Kalkulator regresji liniowej
Dopasuj prostą do danych. Wklej sparowane wartości X i Y, aby otrzymać równanie regresji oraz R².
Zobacz, jak wykonać obliczenia samodzielnieWpisz wartości
Wyniki aktualizują się podczas wpisywania.
Jak wprowadzić dane
Użyj dwóch pól: jednego dla wartości zmiennej objaśniającej X i drugiego dla wyników Y. Rozdziel liczby przecinkami lub nowymi liniami. Obie listy muszą mieć tę samą długość i kolejność, aby każda para dotyczyła tej samej osoby lub obserwacji. W liczbach dziesiętnych na listach używaj kropki.
R² — dopasowanie
Sprawdź dane
Wpisz poprawne wartości, aby zobaczyć wynik. Skorzystaj z podpowiedzi przy polach lub instrukcji wprowadzania danych.
Kalkulator regresji liniowej dopasowuje prostą do par danych, np. czasu nauki i wyniku testu. Pokazuje, jak przewidywana wartość jednej zmiennej zmienia się wraz z drugą, i pozwala ocenić dopasowanie modelu. Równanie można wykorzystać do oszacowań, pamiętając, że sam związek nie dowodzi przyczynowości.
Oblicz samodzielnie
Przykład: dopasuj prostą do par (1, 2), (2, 4) i (3, 3).
Prześledź przykład, a następnie wykonaj te same kroki dla własnych danych.
Oblicz średnie oraz sumy kwadratów i iloczynów odchyleń
Średnia X = 2; średnia Y = 3; Sxx = (−1)² + 0² + 1² = 2; Sxy = (−1 × −1) + (0 × 1) + (1 × 0) = 1Sxx jest sumą kwadratów odchyleń X od średniej, a Sxy sumą iloczynów sparowanych odchyleń X i Y.
Oblicz nachylenie
Nachylenie b = Sxy ÷ Sxx = 1 ÷ 2 = 0.5Oblicz wyraz wolny i równanie
Wyraz wolny a = średnia Y − b × średnia X = 3 − 0.5 × 2 = 2; przewidywane Y = 2 + 0.5XOblicz udział wyjaśnionej zmienności
Syy = (−1)² + 1² + 0² = 2; R² = Sxy² ÷ (Sxx × Syy) = 1 ÷ 4 = 0.25Oblicz statystykę testową dopasowanej prostej
F = R² × (n − 2) ÷ (1 − R²) = 0.25 × 1 ÷ 0.75 ≈ 0.3333Prawdopodobieństwo prawego ogona rozkładu F o 1 i 1 stopniu swobody wynosi około 0,6667. Wyznacz je z tablicy lub numerycznie.
Obliczenie wartości p zakłada niezależne, w przybliżeniu normalne błędy o stałej wariancji. Unikaj ekstrapolacji prostej daleko poza obserwowany zakres X.
Sprawdź wynik w kalkulatorzeDostępne w PaperSurvey.io
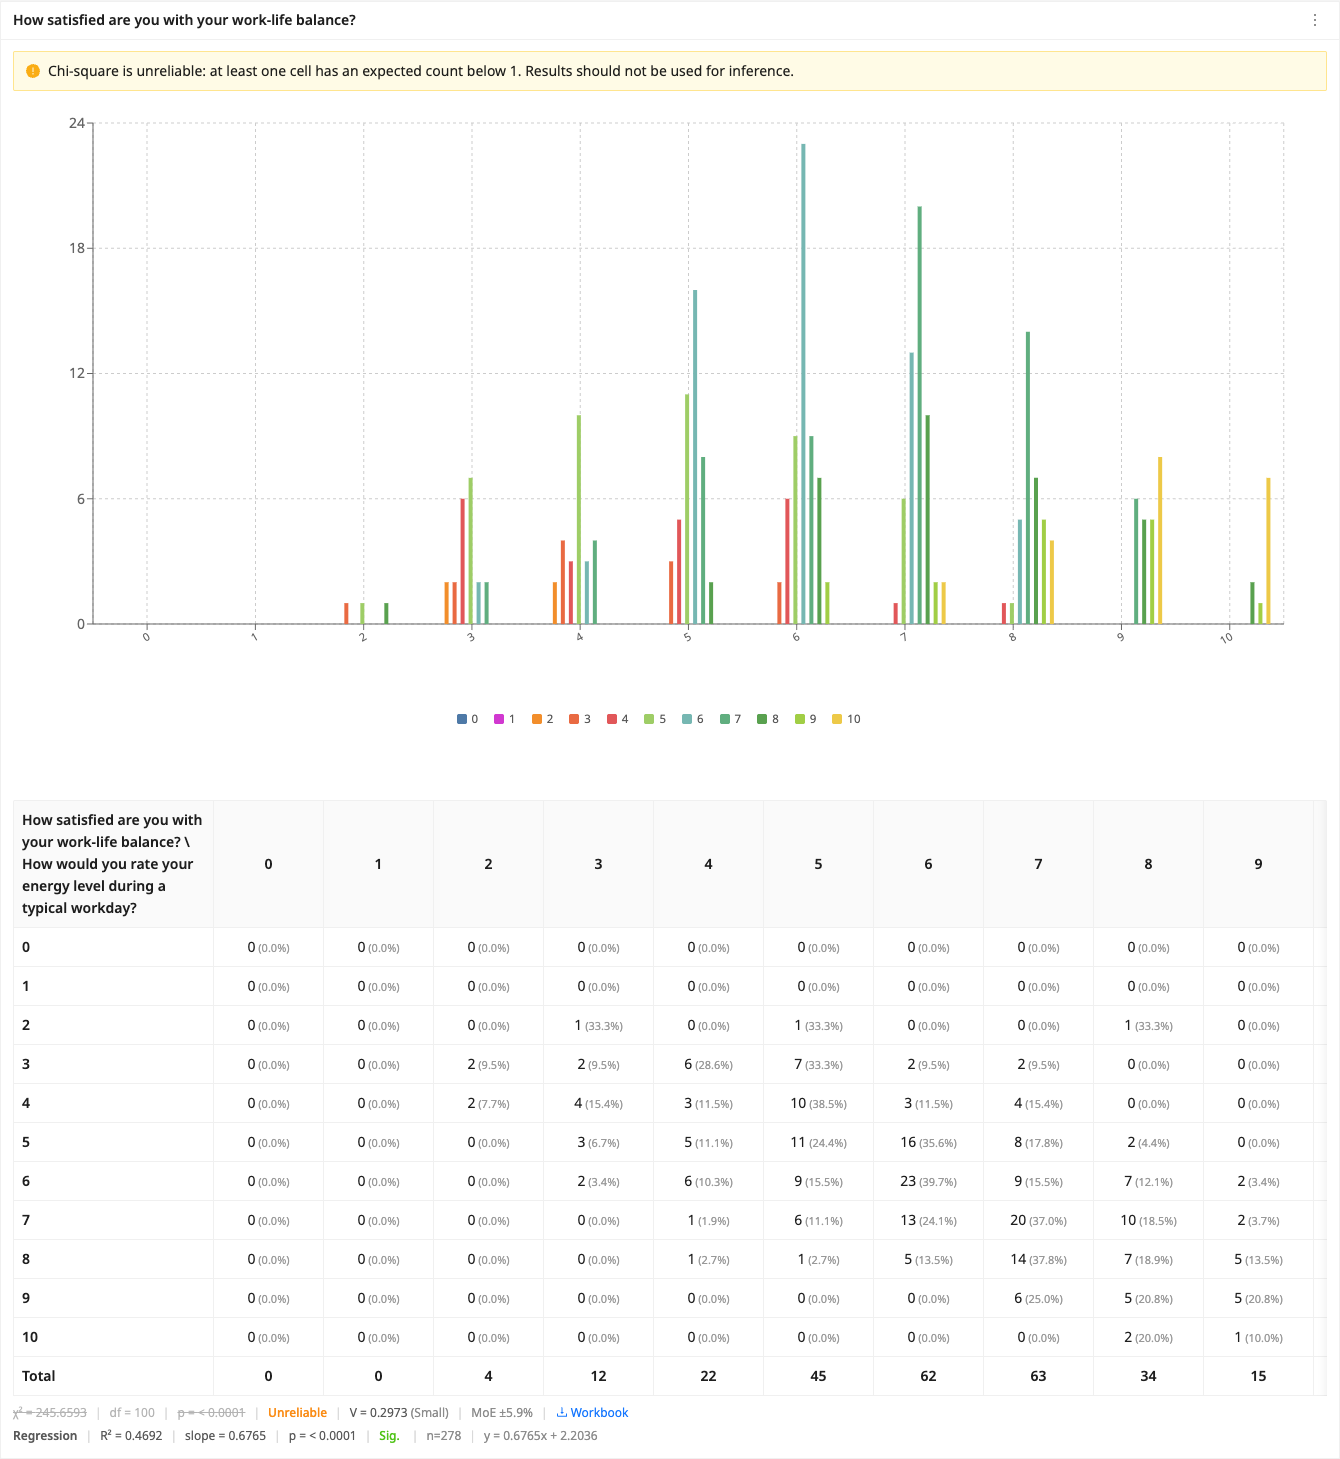
Porównaj dwie skale liczbowe w trybie zaawansowanym, aby odczytać równanie, R² i wartość p regresji.
Przykłady zastosowań
- Nauczyciele: Nauczyciel sprawdza związek między czasem nauki uczniów a wynikami egzaminu.
- Właściciele małych firm: Właściciel sklepu analizuje, czy większe miesięczne wydatki na reklamę wiążą się z wyższą sprzedażą.
- Organizatorzy wydarzeń: Organizator sprawdza związek między ceną biletów a liczbą uczestników wcześniejszych wydarzeń.
Co daje regresja
Prosta regresja liniowa dopasowuje linię przewidującą Y na podstawie X. Nachylenie określa zmianę przewidywanego Y na jednostkę X. R², od 0 do 1, to część zmienności Y wyjaśniona przez dopasowany model.
Kiedy go używać?
Użyj regresji, gdy dla każdej osoby, produktu lub dnia masz dwie wartości i chcesz opisać ich związek. Zmienną objaśniającą może być czas nauki lub wydatki na reklamę, a wynikiem — punkty z testu albo sprzedaż. Kalkulator wyznacza najlepiej dopasowaną prostą i pokazuje jej równanie oraz dopasowanie. Równanie umożliwia przewidywanie Y dla wybranego X, o ile liniowy model jest odpowiedni i zachowasz ostrożność poza zakresem danych.
Co oznacza wynik?
Otrzymasz nachylenie, wyraz wolny i R². Nachylenie określa zmianę przewidywanego Y przy wzroście X o jednostkę. Wyraz wolny to przewidywane Y dla X = 0; nie zawsze ma praktyczne znaczenie, zwłaszcza gdy zero leży poza zakresem danych. R² opisuje dopasowanie: im bliżej 1, tym większą część zmienności Y wyjaśnia model. Ocena, czy wynik jest wystarczający, zależy od dziedziny i celu, a nie od jednego uniwersalnego progu.
Jakich błędów unikać
Dobre dopasowanie nie dowodzi przyczynowości. Obie listy muszą mieć tę samą długość i zachowywać właściwe pary obserwacji. Dwa lub trzy punkty to za mało do wiarygodnej oceny zależności. Regresja liniowa może nie oddawać związku krzywoliniowego, a obserwacje odstające mogą silnie zmienić prostą. Unikaj przewidywań daleko poza obserwowanym zakresem X.
Jak korzystać z kalkulatora
- W pierwszym polu wpisz wartości zmiennej objaśniającej X, rozdzielając je przecinkami lub nowymi liniami.
- W drugim polu wpisz wartości Y w tej samej kolejności, aby każda para dotyczyła tej samej obserwacji.
- Sprawdź, czy obie listy mają tyle samo wartości. Wynik zaktualizuje się automatycznie.
- Odczytaj nachylenie i wyraz wolny, aby zapisać równanie, oraz R², aby ocenić dopasowanie prostej.
Przykład obliczeń
Nauczyciel zapisuje czas nauki pięciu uczniów: 1, 2, 3, 4 i 5 godzin, oraz ich wyniki: 52, 58, 63, 71 i 74 punkty. Dopasowana prosta to w przybliżeniu wynik = 46,5 + 5,7 × liczba godzin. Każda dodatkowa godzina wiąże się w tym modelu ze wzrostem przewidywanego wyniku o 5,7 punktu, a R² wynosi około 0,99. Dla 6 godzin model przewiduje około 81 punktów, lecz jest to już ekstrapolacja poza obserwowany zakres i wymaga ostrożności.
Często zadawane pytania
Co wpisać w poszczególnych polach?
Wpisz wartości X w jednym polu, a odpowiadające im wyniki Y w drugim. Rozdziel liczby przecinkami lub nowymi liniami i zachowaj identyczną kolejność obserwacji.
Skąd wziąć te dane?
Z własnych danych, np. arkusza, ankiety lub raportu sprzedaży. Każda para powinna obejmować dwa pomiary dotyczące tej samej osoby, daty lub obiektu.
Co oznacza nachylenie prostej?
Nachylenie mówi, o ile zmienia się przewidywane Y, gdy X wzrasta o jedną jednostkę. Nachylenie 5 oznacza wzrost przewidywanego wyniku o 5 jednostek na każdą dodatkową jednostkę X.
Jaka wartość R² jest dobra?
R² mieści się od 0 do 1 i opisuje część zmienności Y wyjaśnioną przez model w tych danych. Wyższa wartość oznacza lepsze dopasowanie, ale nie ma uniwersalnego progu dobrego wyniku. Oceniaj go w kontekście dziedziny, celu analizy i jakości przewidywań.
Czy silny związek dowodzi przyczynowości?
Nie. Regresja pokazuje związek między zmiennymi. Inny czynnik może wpływać na obie, dlatego do wnioskowania przyczynowego potrzebny jest odpowiedni projekt badania.
Zacznij korzystać z PaperSurvey.io
Pierwsze 14 dni bez opłat. Konto założysz od razu, bez podawania karty płatniczej.